Ya tengo trazas de mi agente. ¿Y ahora qué?
Agentes de IA en producción
Un agente LLM en producción, de principio a fin: testear con evals antes de desplegar, observar qué hace en producción con Langfuse, operar y mejorar con lo que ves, y asegurar la frontera con Bedrock Guardrails. Fallos y soluciones reales de un agente en vivo.
4 artículos
En la Parte 2 de esta serie monté el tracing de mi agente sobre Strands + Amazon Bedrock AgentCore con Langfuse, y cerré con el bucle que de verdad justifica todo el montaje: una traza mala se convierte en un caso de eval permanente. Pero al publicarlo me di cuenta de que me había saltado la pregunta más honesta, la que yo mismo me hice el primer día con el dashboard delante: vale, me llegan las trazas… ¿y ahora qué hago con ellas?
Esta serie recorre el ciclo completo de llevar un agente a producción: testear antes de desplegar → observar qué hace en producción → operar y mejorar con lo que ves → asegurar la frontera. Esta es la parte 3, operar y mejorar.
Porque tener observabilidad no es el objetivo. Mirar un dashboard bonito un rato tampoco. El objetivo es usar lo que ves para que el agente responda mejor la semana que viene que esta. Este post es eso: el puñado de cosas que hago de verdad con las trazas, en orden de lo que más me ha servido, y una cosa que todavía me falta por montar.
No busques las respuestas malas a ojo
El primer error que cometí fue abrir trazas al azar a ver si pillaba algo raro. Con cuatro peticiones al día funciona; en cuanto hay volumen, es como leer logs línea a línea. No escala y, sobre todo, no es donde está el problema.
Lo que hago ahora es dejar que el score me lleve directo a las sospechosas. El evaluador LLM-as-a-judge que ya corre sobre cada traza (lo configuré en la Parte 2) deja un número por respuesta (Conciseness, Hallucination), y la pestaña de Scores tiene un buscador que entiende esos valores. Un value:<0.5 sobre source:EVAL me filtra solo los turnos flojos; name:Hallucination value:>0.5 me saca las respuestas que probablemente se inventaron algo.
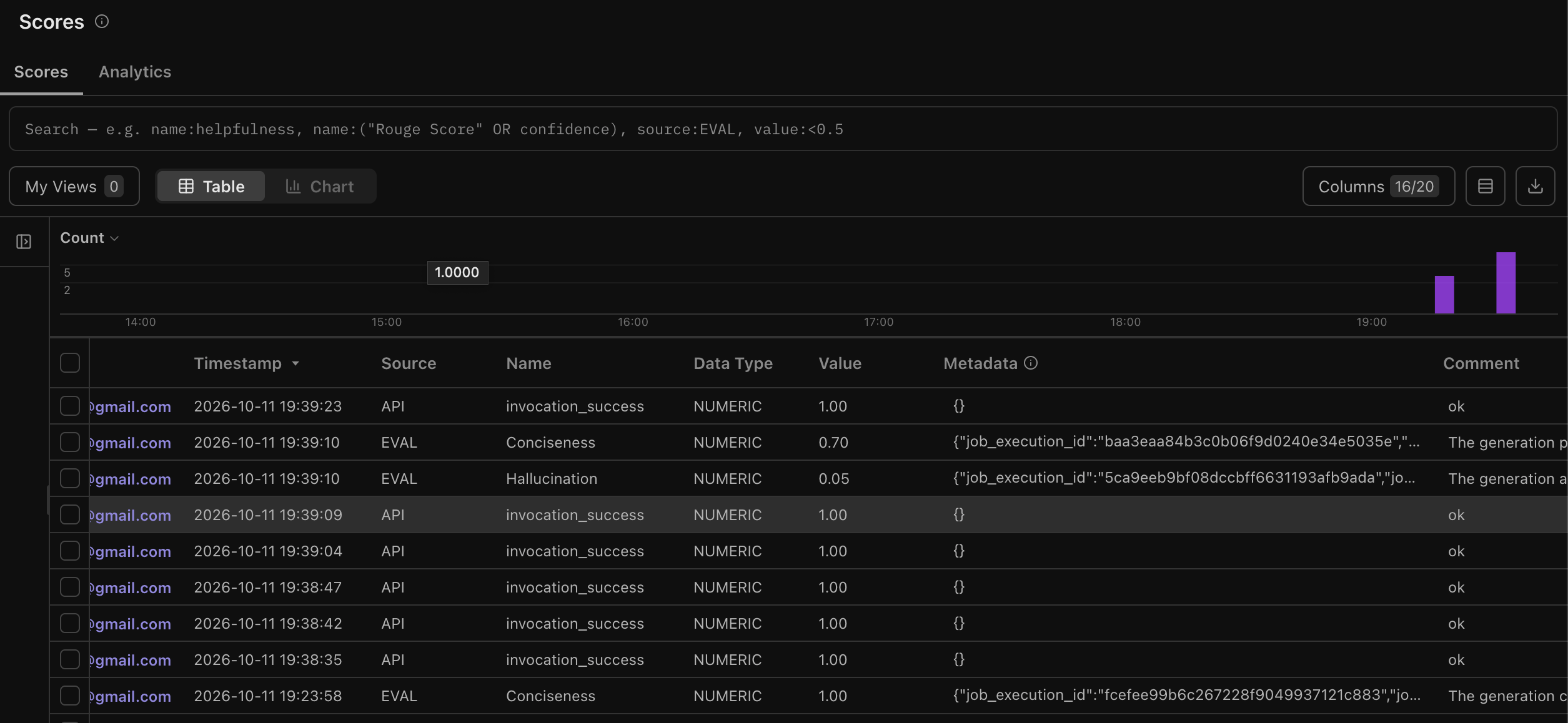
De una lista de cientos de peticiones paso a las cinco o seis que merece la pena abrir. Y entonces sí: entro en la traza, leo la pregunta del usuario, veo qué tools llamó y con qué parámetros, y casi siempre el porqué del fallo salta a la vista: eligió la tool equivocada, le faltó contexto, o el system prompt le empujó a divagar. El score no me dice qué arreglar; me dice dónde mirar, que con volumen es la mitad del trabajo.
Convierte el fallo en un test, no en una anécdota
Encontrar una respuesta mala y arreglarla a mano es tentador, pero es trabajo que se evapora: a la siguiente vez que toques el prompt no tienes forma de saber si la rompiste otra vez. Por eso, cuando una traza destapa un patrón de fallo que se repite, no la cierro: la convierto en un caso de regresión.
Es exactamente el bucle de la Parte 2 (de la traza al eval), pero visto desde el día a día es una rutina muy simple: encuentro el turno malo por score, extraigo de la traza el input real del usuario y la propiedad que debería cumplirse (la tool correcta, el parámetro correcto, el idioma correcto), y lo añado a la suite que corre antes de cada despliegue. Mis casos más útiles son aserciones deliberadamente aburridas que vinieron de bugs reales, no de prompts de test inventados.
El cambio de mentalidad es ese: en vez de probar tres chats a mano cada vez que toco el agente, acumulo los casos difíciles y los corro todos de golpe. Lo que antes era “creo que no lo he roto” pasa a ser “la suite dice que no lo he roto”.
Lo que las trazas te enseñan gratis: tools, coste y latencia
No todo lo que saco de las trazas es cazar fallos. Hay dos cosas que miro de pasada y que me ahorran dinero y tiempo sin montar nada extra.
La primera son los patrones de uso de tools. Al abrir el árbol de una invocación veo qué tools se llamaron y en qué orden, y Langfuse muestra en el panel de atributos tanto el nombre de la tool como su propia descripción, el criterio con el que el modelo decidió usarla:
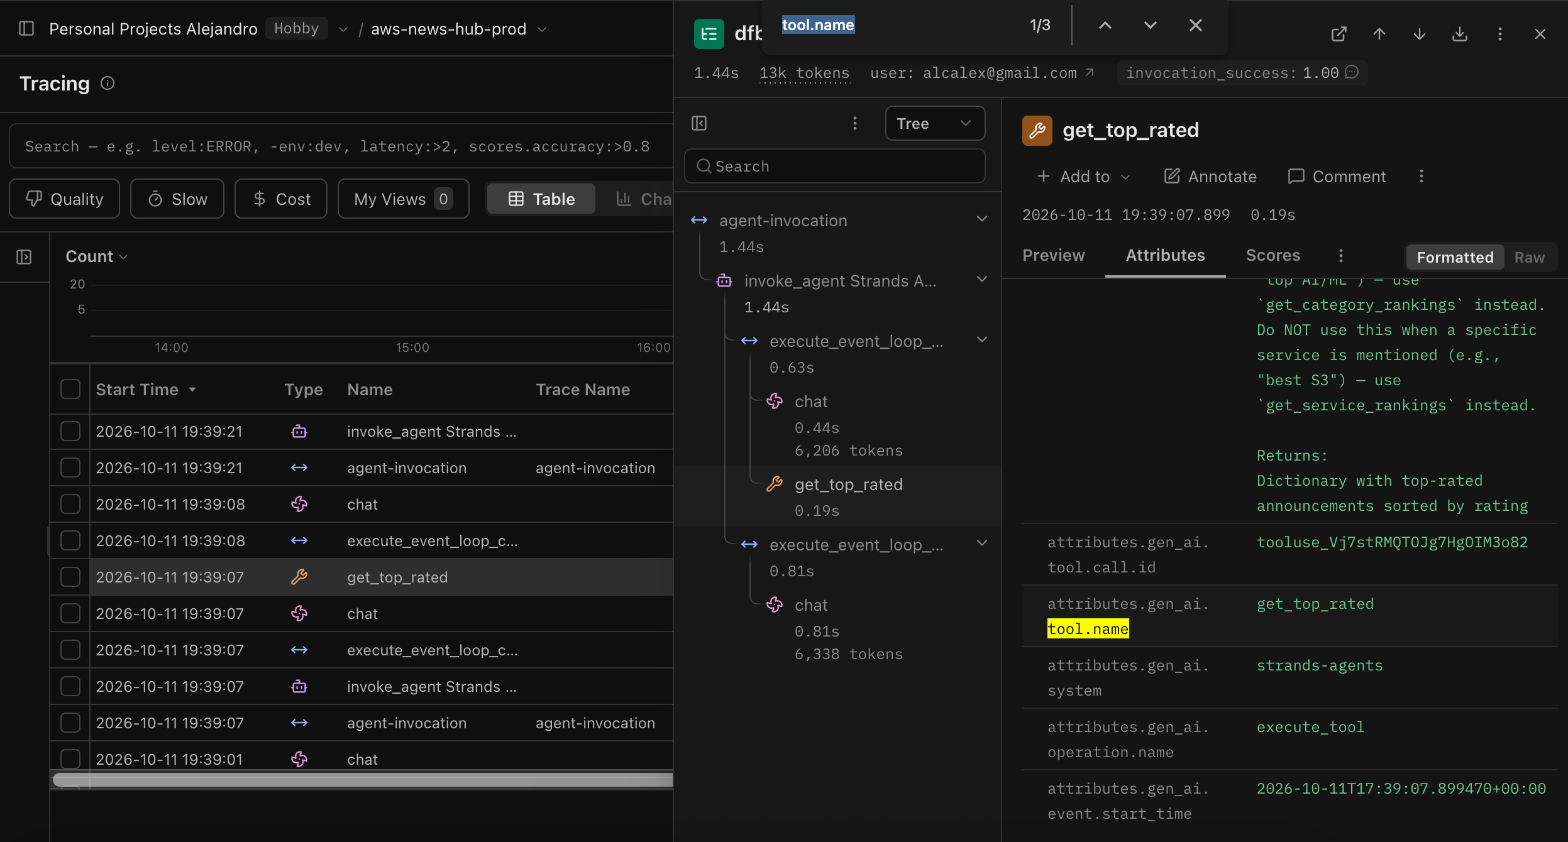
Ver esto junto me deja detectar cosas que de otra forma no notaría: una tool que se llama siempre y nunca aporta, o el modelo encadenando varios ciclos del event loop para algo que debería ser directo. Casi siempre la causa está en una descripción de tool ambigua o en un system prompt que empuja de más, y se arregla ahí, no en el código.
La segunda es coste y latencia. Los botones de Cost y Slow me ordenan las trazas por lo que más duele, y con un modelo por token eso se traduce en factura. Saber qué turnos son caros o lentos me dice dónde optimizar antes de tener tráfico de verdad, no después de recibir la sorpresa.
Ninguna de las dos requiere evaluadores ni configuración: están ahí desde el momento en que las trazas llegan.
Lo que ya corre, y lo que todavía me falta
Puesto en orden, lo que tengo montado hoy es: el tracing que captura cada invocación, y el evaluador LLM-as-a-judge que puntúa cada traza en producción. Eso es la automatización que de verdad importa, y ya está en marcha. El resto (cazar por score, convertir en regresión, mirar tools y coste) es trabajo que hago yo encima de esa base.
Y aquí está lo honesto: hay un hueco que todavía no he cerrado. Ahora mismo, para enterarme de que algo se está degradando, tengo que acordarme de mirar los Scores. Eso funciona mientras el proyecto es pequeño y lo miro a menudo, pero no es una red de seguridad de verdad. El siguiente paso que tengo pendiente es montar una alerta (Langfuse las trae en v4) que me avise sola si el Hallucination medio sube de un umbral, o si empiezan a entrar errores de la propia integración, para enterarme de un bajón sin tener el dashboard abierto. Mientras no la tenga, soy yo el sistema de alerta, y eso es exactamente lo que quiero quitarme de encima.
Si para enterarte de una degradación tienes que acordarte de mirar el dashboard, no tienes una red de seguridad: te tienes a ti. Una alerta sobre el score medio es lo que convierte la observabilidad en algo que trabaja por ti.
Si tuviera que resumir el método en una frase: deja que el score te lleve a las trazas malas, convierte las que se repiten en tests que corran solos, y pon una alerta encima para no depender de tu memoria. El dashboard es bonito; esto es lo que hace que el agente mejore.
El método en una línea: deja que el score te lleve a las trazas malas → convierte las que se repiten en tests que corran solos → pon una alerta encima para no depender de tu memoria.
Con esto cierro la parte de observabilidad de la serie. Lo que queda es la otra frontera del agente (qué pasa cuando alguien intenta manipularlo, o cuando una consulta legítima dispara un falso positivo), y eso lo cuento en la Parte 4, Mi agente es público. ¿Y si alguien intenta manipularlo?, porque lo veo más un problema de seguridad que de observabilidad.
El agente del que hablo en este post, el asistente de IA de AWS Announcements Hub, es el que puedes probar en news.playingaws.com.