Mi agente ya está en producción. ¿Qué está haciendo ahí dentro?
Agentes de IA en producción
Un agente LLM en producción, de principio a fin: testear con evals antes de desplegar, observar qué hace en producción con Langfuse, operar y mejorar con lo que ves, y asegurar la frontera con Bedrock Guardrails. Fallos y soluciones reales de un agente en vivo.
4 artículos
En la Parte 1 de esta serie conté la suite de evals que ejecuto antes de desplegar mi agente de IA: la que caza que elija la tool equivocada, que le pase mal los parámetros, que rechace una petición válida, que responda en otro idioma o que suelte una respuesta infiel a lo que devolvió la tool. Esa suite me da mucha confianza antes de desplegar.
Esta serie recorre el ciclo completo de llevar un agente a producción: testear antes de desplegar → observar qué hace en producción → operar y mejorar con lo que ves → asegurar la frontera. Esta es la parte 2, observar.
Pero no me dice nada del día siguiente, cuando un usuario real pregunta algo que a mí nunca se me ocurrió meter en una eval. Y ahí es donde se juega de verdad la calidad de un agente. Para ver ese “día siguiente” necesitaba trazas, y este post es cómo las monté sobre Strands + Amazon Bedrock AgentCore con Langfuse, qué me enseñaron, y por qué el verdadero premio no es un dashboard bonito sino poder convertir un fallo de producción en un test permanente.
Lo que quería poder ver (y por qué los logs no bastan)
Para cada petición quería poder reconstruir la historia completa: qué preguntó exactamente el usuario, qué llamadas al modelo se dispararon, qué tools se usaron y con qué parámetros, cuánto tardó cada paso, si intervino un guardrail, si la cosa falló y cuántos tokens costó.
Partes de eso caben en logs de aplicación. El problema no es tener los datos, es reconstruirlos. Una invocación de un agente no es un evento: es un árbol de llamadas al modelo, pasos de orquestación, tools y llamadas a APIs de AWS, todo colgando de una misma pregunta. Yo quería inspeccionar ese árbol como una sola ejecución, no reensamblarlo a mano cruzando líneas de log por timestamp. Para eso uso Langfuse, en su versión cloud gestionada (tiene plan gratuito, de sobra para un proyecto como este).
Aquí conviene aclarar algo, porque es la primera pregunta que recibo: no uso Langfuse porque AgentCore sea una caja negra. No lo es. Amazon Bedrock AgentCore trae observabilidad nativa integrada con Amazon CloudWatch: traza la ejecución, enseña sesiones y trazas, da métricas de latencia, tokens y errores. Uso los dos porque me cubren workflows distintos: la observabilidad de AWS es el sitio natural para entender el runtime y la parte AWS de la app, y Langfuse me da una vista centrada en LLM donde veo juntas las conversaciones, las llamadas al modelo, la ejecución de tools y las señales de evaluación. Me interesa especialmente este recorrido:
traza de producción → consulta que falla → nueva eval → fix → despliegue
Si hoy quisiera un stack 100% AWS-native, AgentCore Observability junto con AgentCore Evaluations sería una opción perfectamente razonable. Este post es, simplemente, el setup que yo uso de verdad.
Enganchar Langfuse sin pelearme con la telemetría de AWS
Esta fue la parte que más investigación me llevó, y la que creo que puede ahorrarte un dolor de cabeza. La clave está en entender que OpenTelemetry tiene un TracerProvider global, y que tanto AWS como Langfuse quieren usarlo. Strands emite telemetría OpenTelemetry; AgentCore inyecta AWS Distro for OpenTelemetry (ADOT) en el runtime y la usa para su observabilidad nativa; y Langfuse también habla OpenTelemetry. Si dos integraciones dan por hecho que son las dueñas de ese provider, la cosa se enreda rápido.
Antes de nada, una decisión de higiene: separo test de producción en dos proyectos distintos de Langfuse, para no mezclar nunca mis ejecuciones locales de evals con usuarios reales.
| Proyecto | Tráfico |
|---|---|
| test | Suite local de evals y agente no productivo |
| prod | Peticiones reales de producción |
Langfuse soporta metadata de entorno, así que no es obligatorio partir en dos proyectos; yo prefiero la separación dura. Cuando abro producción, sé que estoy mirando producción y nada más.
Hecho eso, hay dos caminos. Si solo quieres Langfuse, la integración oficial documenta el camino directo: pones DISABLE_ADOT_OBSERVABILITY=true, configuras el endpoint OTLP y las cabeceras, y listo. Si lo único que me importara fuese Langfuse, iría por ahí sin pensarlo.
Pero yo quería los dos destinos a la vez, sin renunciar a la ruta de telemetría de AWS:
1
2
3
                  ┌──► observabilidad AWS
Strands ─► OTEL ──┤
                  └──► Langfuse
El truco para conseguirlo es no crear un segundo TracerProvider global, sino enganchar Langfuse como un exporter más al provider que ADOT ya dejó montado. Todo el código extra se reduce a esto:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import base64
from opentelemetry import trace as otel_trace
from opentelemetry.sdk.trace import TracerProvider as SdkTracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter


def setup_langfuse_otel(public_key, secret_key, host):
    provider = otel_trace.get_tracer_provider()
    if not isinstance(provider, SdkTracerProvider):
        return   # ADOT aún no lo ha montado; no instalo uno nuevo

    auth = base64.b64encode(f"{public_key}:{secret_key}".encode()).decode()
    exporter = OTLPSpanExporter(
        endpoint=f"{host}/api/public/otel/v1/traces",
        headers={"Authorization": f"Basic {auth}",
                 "x-langfuse-ingestion-version": "4"},
    )
    provider.add_span_processor(BatchSpanProcessor(exporter))   # <- reutilizo el provider que ya existe
La única línea que importa de verdad es provider.add_span_processor(...): reutilizo el provider que ya existe en lugar de instalar otro global. Este trozo es, además, el más sensible a versiones de toda la integración (OpenTelemetry, AgentCore, Strands y Langfuse evolucionan por su cuenta), así que lo mantengo pequeño y aislado a propósito.
No crees un segundo
TracerProviderglobal: si tanto ADOT como Langfuse intentan ser dueños del provider, la telemetría se te enreda y acabas depurando spans que desaparecen. Engancha Langfuse como un exporter más sobre el provider que ADOT ya montó.
Con el exportado resuelto, envuelvo cada petición completa en un root span, para que los spans internos de Strands, las llamadas al modelo y las tools cuelguen de un mismo contexto de ejecución:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
from opentelemetry import trace as otel_trace
from opentelemetry import context as otel_context

tracer = otel_trace.get_tracer("aws-announcements-agent")
root_span = tracer.start_span("agent-invocation", attributes={
    "langfuse.trace.name": "agent-invocation",
    "langfuse.trace.user_id": user_id,
    "langfuse.environment": environment,
})
token = otel_context.attach(otel_trace.set_span_in_context(root_span))
try:
    response = await run_agent(prompt)
    root_span.set_attribute("status", "ok")
except Exception:
    root_span.set_attribute("status", "error")
    raise
finally:
    otel_context.detach(token)
    root_span.end()
Mi código real guarda además metadata de petición y respuesta, y maneja el camino del guardrail para que una invocación bloqueada no desaparezca de la observabilidad. Marco tres resultados operativos (ok, guardrail, error) y, a propósito, no los llamo “quality scores”: una petición puede terminar perfectamente y aun así dar una mala respuesta. El resultado operativo y la calidad de la respuesta son señales distintas, y mezclarlas solo te confunde después.
Lo que una traza buena me enseña
Con esto montado, una petición cualquiera produce un árbol como este, y puedo recorrerlo entero:
1
2
3
4
5
6
7
agent-invocation
  ├── execute_event_loop_cycle
  │     ├── chat
  │     │     └── Bedrock model invocation
  │     └── compare_services
  │           └── S3.GetObject
  └── DynamoDB.GetItem
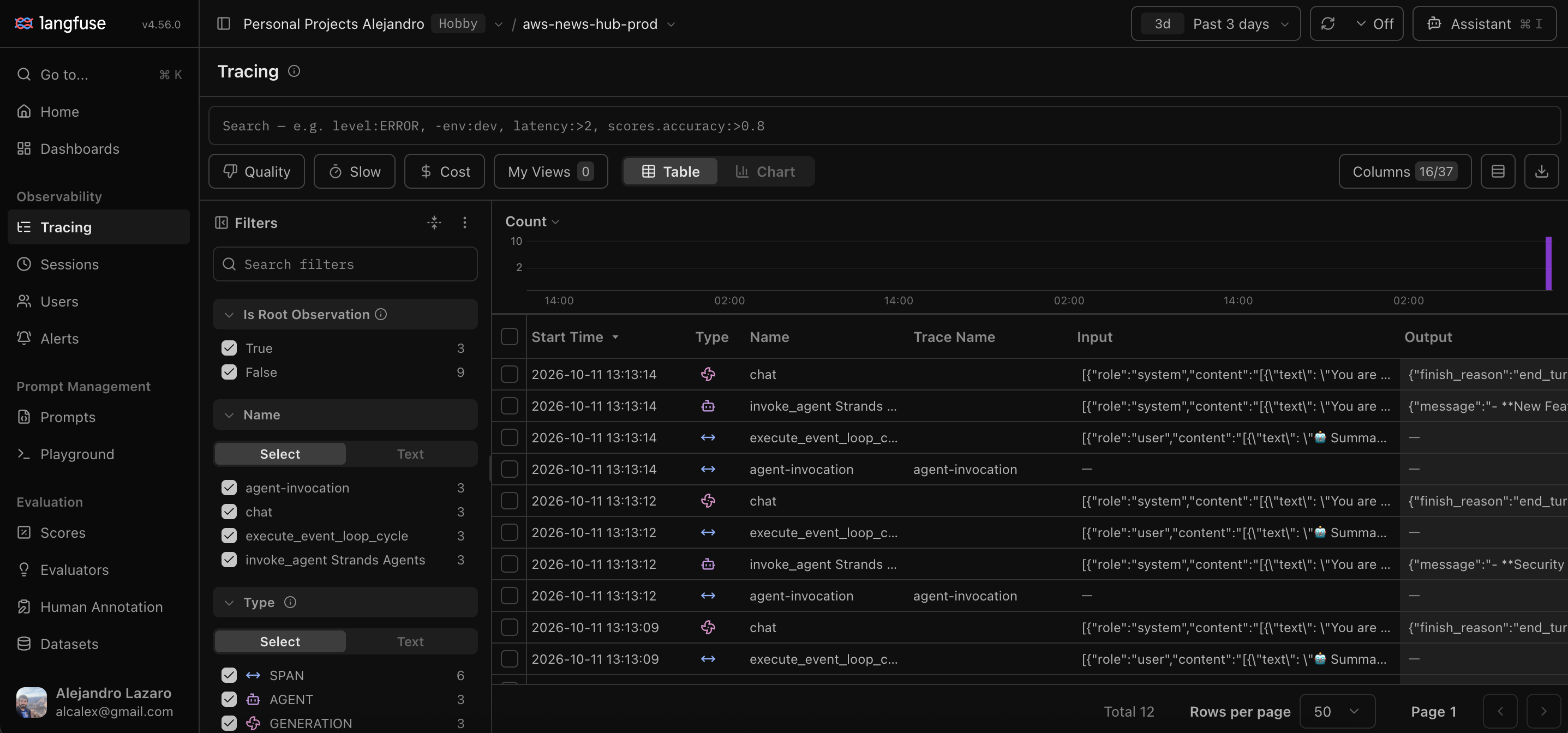
Así es como se ve en Langfuse. La lista de trazas me da la vista de pájaro, cada invocación con sus spans de chat, invoke_agent y execute_event_loop_cycle:
Y al abrir una traza concreta tengo el árbol real con su timeline de latencias por span, el modelo que se usó (eu.amazon.nova-2-lite), los tokens y las señales de evaluación (Conciseness, Hallucination) ya enganchadas arriba:
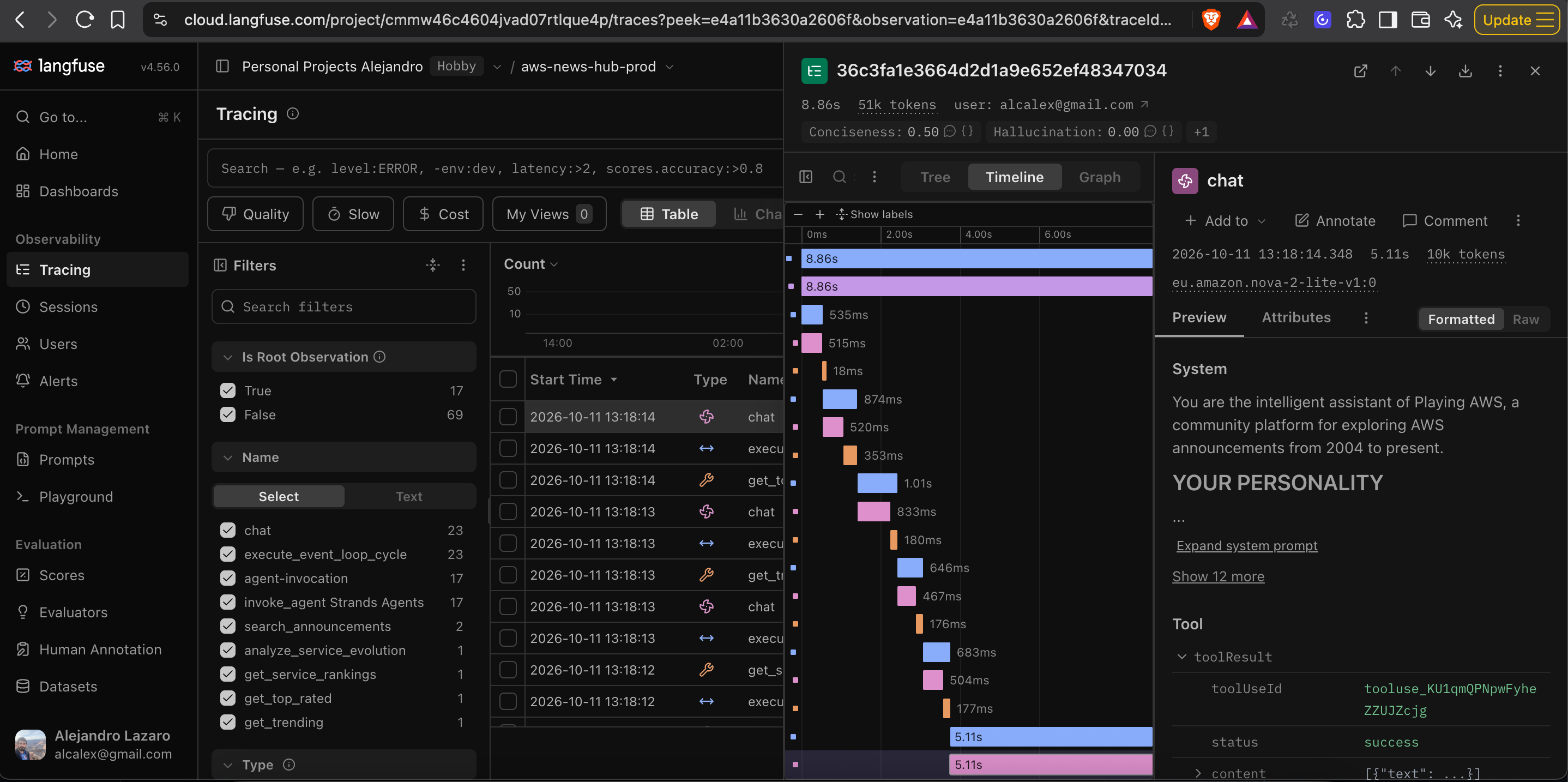
Mirándolo respondo cosas que antes solo podía intuir: si el agente llegó a buscar, si llamó a una tool de más, qué sort_order usó, si el retraso estaba en el modelo o en una API de AWS, si el guardrail cortó la petición, cuánto contexto le llegó al modelo y qué recibió el usuario al final. Y la lección más útil es contraintuitiva: las trazas que más importan casi nunca son los fallos duros. Un 500 se ve a la primera. Lo peligroso es la respuesta segura de sí misma y aparentemente impecable, generada con un parámetro de tool incorrecto. Eso no sale en ningún log de errores, y es exactamente lo que una traza te deja ver.
Las trazas que más importan casi nunca son los
500: esos ya los ves. Son las respuestas seguras y plausibles generadas con el parámetro equivocado, que ningún log de errores registra.
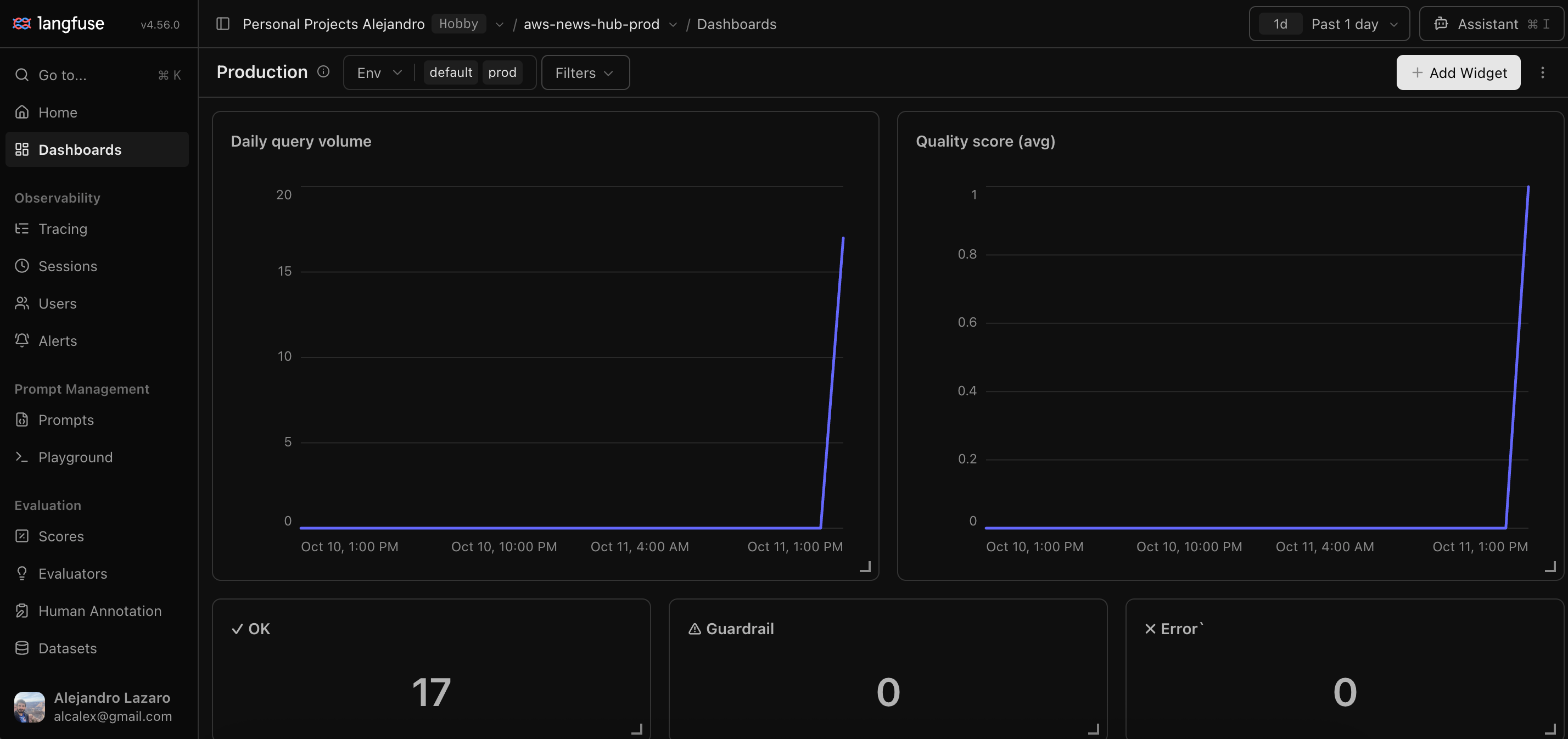
Mi instinto inicial, por cierto, fue montar un dashboard el primer día. En la práctica aprendí mucho más leyendo trazas sueltas una a una. Solo cuando tuve tráfico suficiente añadí una vista de producción pequeña, alrededor de las señales que de verdad me llevan a actuar: volumen de invocaciones, latencia, errores, intervenciones del guardrail, uso de tokens y señales de evaluación. No convierto cada métrica disponible en un widget; si una gráfica no me lleva a ninguna acción, no la necesito.
De una mala traza a un test permanente
Esta es la razón de fondo por la que mantengo todo el tinglado del tracing, y el momento en que la serie se cierra sobre sí misma. Supón que un usuario real pregunta:
what was the first announcement about serverless?
La respuesta es incorrecta. Abro la traza y voy directo al span de la tool, donde Langfuse me enseña el nombre de la tool que eligió el modelo y los argumentos exactos con los que la llamó, justo lo que un log de errores nunca me daría:
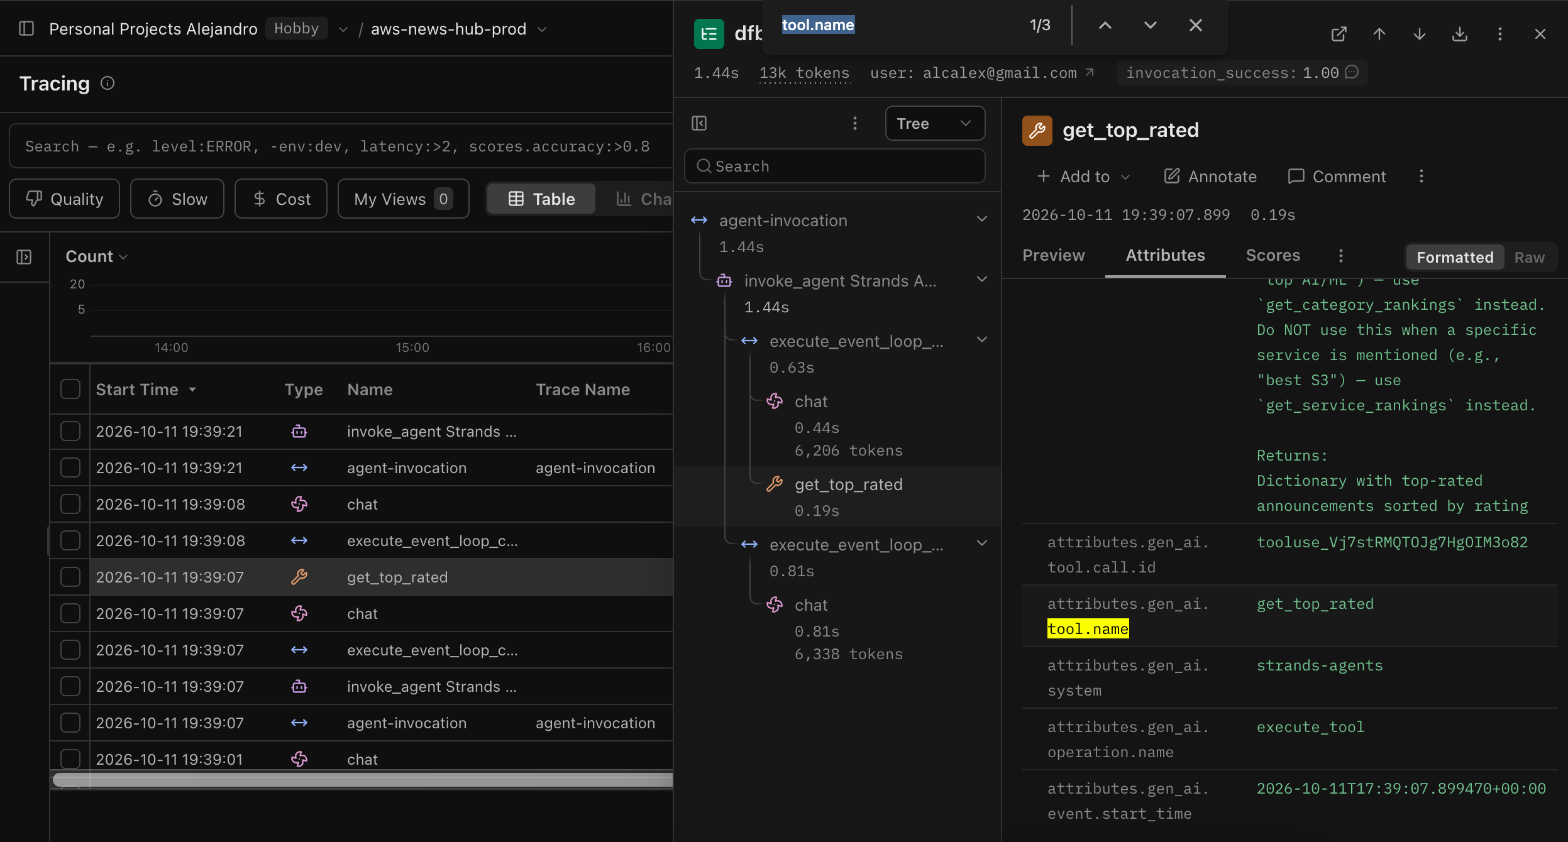
Y ahí está el problema, a la vista en los parámetros:
1
search_announcements(query="serverless", sort_order="desc")
A partir de aquí deja de ser el típico “la IA dio una mala respuesta”, que no se puede ni reproducir ni arreglar, y se convierte en algo concreto y accionable:
1
2
input:    "what was the first announcement about serverless?"
expected: sort_order="asc"
Esa consulta se convierte en un nuevo parameter eval dentro de la suite de la Parte 1. Y el ciclo entero queda así:
flowchart LR
    A[Fallo en producción] --> B[Inspeccionar la traza]
    B --> C[Añadir un caso de eval]
    C --> D[Reproducir en local]
    D --> E[Arreglar prompt, schema de tool o código]
    E --> F[Pasar la suite]
    F --> G[Desplegar]
El dashboard está bien, pero es este bucle de feedback, no las gráficas, lo que justifica tener el tracing montado.
Hay un tipo de traza que guardo por un motivo distinto: las intervenciones de Amazon Bedrock Guardrails. Ahí se mezclan dos tráficos muy diferentes (alguien intentando manipular al agente de verdad, y una consulta legítima que dispara un falso positivo) y los dos suman al mismo contador de “guardrail”. Solo la traza me dice cuál de las dos cosas pasó. Por eso no trato una intervención del guardrail como un error ni como una nota de calidad baja: es un resultado operativo que necesita interpretarse. La configuración de Guardrails la cuento en la Parte 4 de esta serie, porque la veo más como un problema de seguridad que como parte del stack de testing.
Evaluar en producción, con mesura
Hasta aquí he contado cómo veo lo que pasa. Pero una cosa es ver una traza y otra usarla para mejorar el agente día a día: cazar las respuestas malas por score en vez de a ojo, convertir las que se repiten en tests de regresión y poner una alerta encima para no depender de mi memoria. Langfuse también puntúa en producción con un juez LLM-as-a-judge, y AgentCore Evaluations ofrece evaluación gestionada desde el lado de AWS. Todo eso (qué hago de verdad con las trazas una vez que llegan) lo cuento en la Parte 3, Ya tengo trazas de mi agente. ¿Y ahora qué?, para no inflar este post, que trata de montar la observabilidad, no de operarla.
Si tuviera que instrumentar otro agente pequeño mañana, empezaría con menos de lo que planeé la primera vez: capturar una invocación completa, asegurarme de que los spans del modelo y las tools cuelgan debajo, guardar el input y el output final que necesito para depurar, separar test de producción, registrar resultados operativos (ok, guardrail, error) y, sobre todo, leer las trazas. Sin dashboard elaborado y sin una docena de evaluadores. Primero haz el agente observable; qué métricas merece la pena graficar se vuelve obvio en cuanto tienes tráfico real que mirar.
Visto desde fuera, la serie entera describe el mismo ciclo por los dos lados: antes de desplegar, los unit tests más las behavioral/parameter evals más las quality evals; después de desplegar, la petición real → la traza → el fallo nuevo → la nueva eval → el fix → el despliegue. La suite protege los comportamientos que ya sé que importan; las trazas de producción encuentran el siguiente. Eso es lo que al final hizo que tocar el agente dejara de parecerse a cambiar un prompt y cruzar los dedos.
El agente del que hablo en este post, el asistente de IA de AWS Announcements Hub con sus evals y su integración de observabilidad, es el que puedes probar en news.playingaws.com.