Kubernetes y EKS: muy potente, muy complejo y no siempre necesario
Kubernetes en AWS
Qué es Kubernetes y qué aporta Amazon EKS, y cómo decidir entre Lambda, ECS, EKS o EC2 en AWS exigiendo un requisito concreto antes de asumir la complejidad de Kubernetes.
2 artículos
Kubernetes me parece una tecnología muy buena y, al mismo tiempo, una de las formas más rápidas de añadir una capa enorme de complejidad a una plataforma que quizá no la necesitaba. Esta es la primera de dos partes. Aquí cuento lo justo sobre Kubernetes y Amazon EKS para poder leer una arquitectura y tomar decisiones sin hacer un curso de administración. En la segunda parte uso ese modelo para responder a la pregunta que de verdad me importa: si hace falta o no.
Mi posición es esta: Kubernetes no es una mala tecnología. Es potente, flexible y se ha convertido en un estándar para ejecutar aplicaciones containerizadas a gran escala. Lo que me hace dudar es el precio de esa potencia: más conceptos, más componentes, más decisiones y más cosas que operar.
En AWS, si un problema se resuelve con una arquitectura serverless o con un servicio gestionado más sencillo, empiezo por ahí. Menos infraestructura que mantener significa más tiempo para la aplicación.
Eso no quita que haya escenarios donde Kubernetes sí tiene sentido.
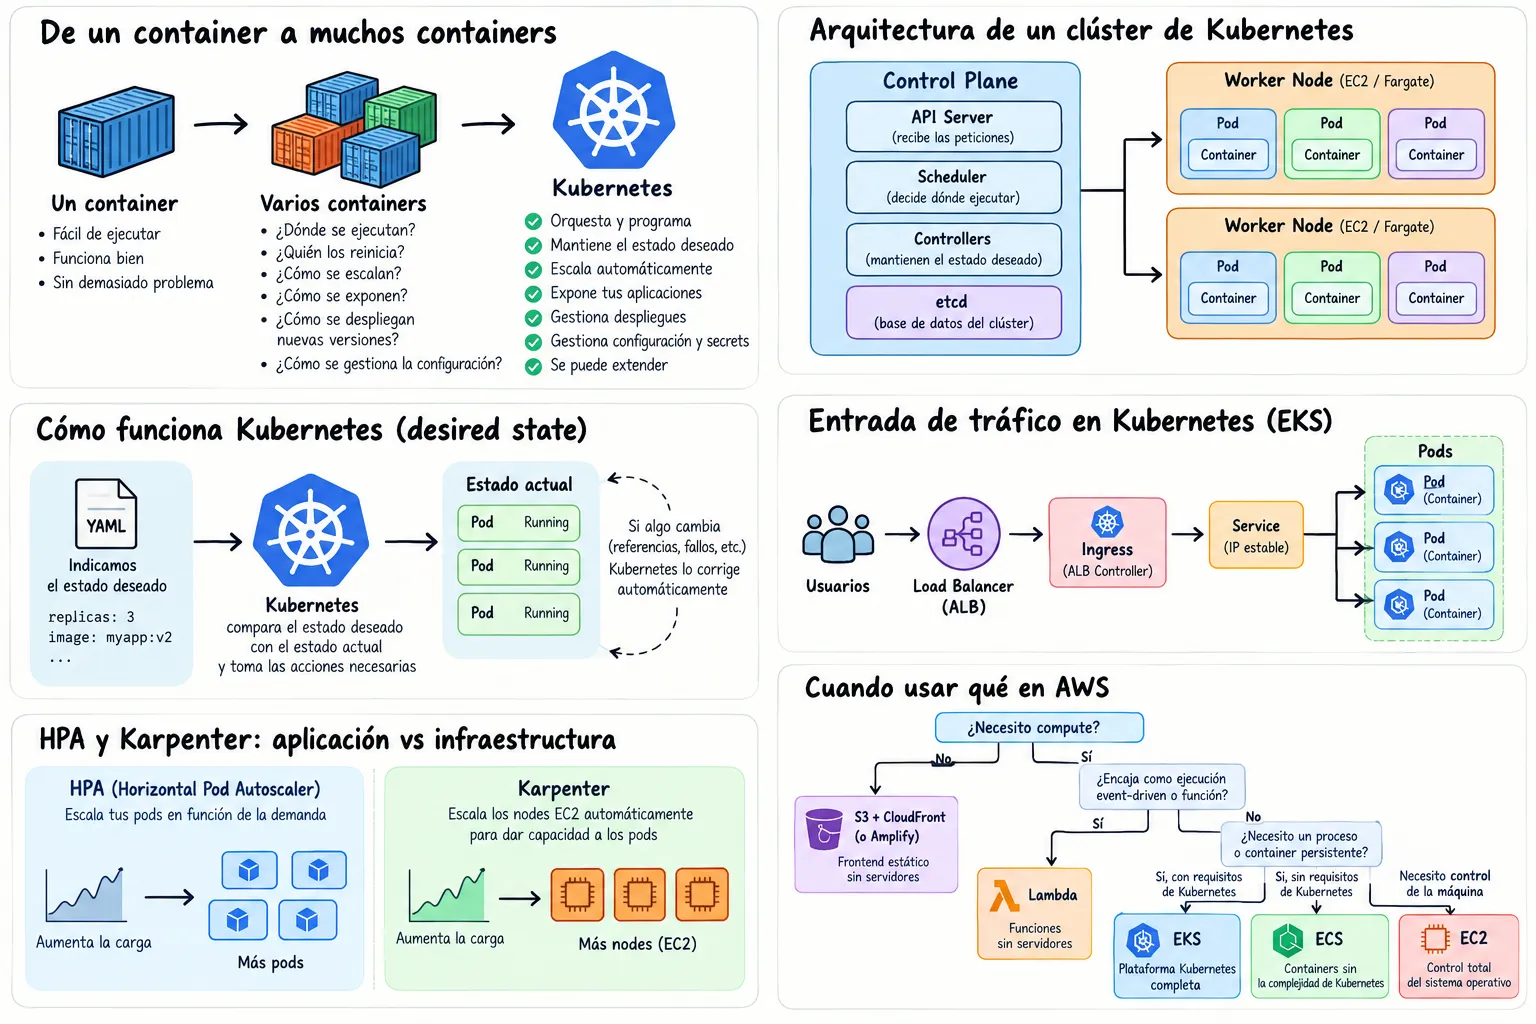 Vista de conjunto de las piezas que voy a recorrer: qué problema resuelve Kubernetes, cómo mantiene el estado deseado, qué cambia con EKS y dónde encajan HPA y Karpenter.
Del container a la plataforma
Ejecutar un container es sencillo:
flowchart LR
    A[Aplicación] --> B[Imagen Docker]
    B --> C[Container]
    C --> D[Servidor]
La cosa cambia cuando hay decenas de servicios, muchas réplicas y varias máquinas. Entonces aparecen preguntas bastante menos divertidas:
- Dónde ejecuto cada container.
- Qué ocurre si una máquina falla.
- Cómo mantengo siempre tres réplicas de una API.
- Cómo escalo cuando sube el tráfico.
- Cómo despliego sin cortar el servicio.
- Cómo se encuentran los servicios entre sí.
Kubernetes intenta resolver precisamente eso: orquestar aplicaciones containerizadas y mantenerlas en el estado que hemos declarado.
Lo importante es el estado declarado: no le decimos a Kubernetes qué hacer paso a paso ni en qué máquina, sino qué queremos tener. Es la diferencia entre estas dos formas de pedir lo mismo:
Imperativo: ejecuta este container en la máquina 4.
Declarativo: quiero tres réplicas de esta aplicación, con esta imagen y estas condiciones.
La primera forma es la de siempre, imperativa y atada a una máquina. La segunda es la de Kubernetes: él se encarga de que la realidad siga coincidiendo con lo que hemos pedido, y si un Pod falla, crea otro para sustituirlo.
flowchart LR
    A[Estado deseado<br/>3 Pods] --> B[Kubernetes]
    B --> C[Pod 1]
    B --> D[Pod 2]
    B --> E[Pod 3]
    E -. falla .-> B
    B -. crea reemplazo .-> F[Pod nuevo]
Este bucle de reconciliación es, para mí, la idea más importante que hay que entender de Kubernetes. Casi todo lo demás se apoya en ella.
El modelo mínimo y los objetos que sí conviene conocer
Un clúster de Kubernetes se puede simplificar mucho. Hay un control plane que decide y coordina, y varios worker nodes que ejecutan el trabajo.
flowchart TB
    CP[Control Plane<br/>decide y coordina]

    subgraph N1[Worker Node]
        P1[Pod]
        P2[Pod]
    end

    subgraph N2[Worker Node]
        P3[Pod]
        P4[Pod]
    end

    CP --> N1
    CP --> N2
El control plane es el cerebro del clúster: mantiene el estado, recibe las peticiones de la API de Kubernetes y decide dónde se ejecuta cada workload. Ahí viven el API Server, el Scheduler, los controllers o etcd.
No hace falta conocer todos sus detalles para entender EKS. Basta con quedarse con que el control plane decide y los worker nodes ejecutan.
Los nodes aportan CPU y memoria, y los Pods son la unidad que Kubernetes despliega sobre ellos, normalmente con el container principal de una aplicación. Como los Pods son efímeros (pueden desaparecer y ser sustituidos por otros), Kubernetes añade más abstracciones por encima.
Kubernetes tiene una cantidad enorme de recursos y APIs, pero para entender una arquitectura a alto nivel no hace falta aprenderlos todos. Yo empezaría por estos:
| Recurso | Idea que debes recordar |
|---|---|
Pod | Donde termina ejecutándose tu container |
Deployment | Mantiene el número y la versión deseados de Pods |
Service | Dirección estable delante de Pods que pueden cambiar |
Ingress / Gateway | Entrada HTTP/HTTPS hacia las aplicaciones |
ConfigMap / Secret | Configuración de los workloads |
Namespace | Separación lógica dentro del clúster |
HPA | Escala el número de Pods |
Con estos siete recursos ya se puede leer una arquitectura típica, como una API detrás de un balanceador, sin entrar todavía en
StatefulSet,DaemonSet, CRDs, Operators ni el resto del ecosistema.
flowchart LR
    U[Usuario] --> ALB[Load Balancer]
    ALB --> I[Ingress]
    I --> S[Service]
    S --> P1[Pod]
    S --> P2[Pod]
    S --> P3[Pod]
Dónde empieza la complejidad de verdad
Hasta aquí Kubernetes puede incluso parecer sencillo. El problema es que un clúster de producción necesita bastante más que Pods y Deployments: networking, DNS, almacenamiento, identidad, autoscaling, observabilidad, balanceadores, secretos, políticas y actualizaciones. Y con todo eso empiezan a aparecer nombres nuevos:
VPC CNICoreDNSkube-proxyEBS CSI DriverAWS Load Balancer ControllerPod IdentityMetrics ServerHPAKarpenterHelmCRDsOperators- y más
Kubernetes no solo ejecuta tu aplicación: introduce una plataforma completa entre tu aplicación y la infraestructura. Esa plataforma puede aportar mucho valor, pero alguien tiene que entenderla, mantenerla, actualizarla, securizarla, observarla y resolver sus problemas.
Esta es una de las razones por las que no elegiría Kubernetes por defecto.
Qué aporta Amazon EKS y qué sigue siendo tuyo
Amazon EKS es el servicio gestionado de Kubernetes de AWS, y la frase que mejor lo resume es que hace que Kubernetes sea más fácil de operar, pero no deja de ser Kubernetes. La diferencia se ve bien comparando responsabilidades:
| Área | Kubernetes autogestionado | Amazon EKS | EKS Auto Mode |
|---|---|---|---|
| Control plane | Lo operas tú | AWS | AWS |
| Alta disponibilidad del control plane | Tú | AWS | AWS |
| API de Kubernetes | Kubernetes | Kubernetes | Kubernetes |
| Nodes / compute | Tú | Varias opciones | AWS automatiza gran parte |
| Networking / almacenamiento / load balancing | Tú | Integraciones y add-ons | Capacidades gestionadas por AWS |
| Workloads | Tú | Tú | Tú |
En EKS estándar seguimos decidiendo cómo ejecutar los nodes, qué add-ons usamos y cómo configuramos muchas piezas de la plataforma. Con EKS Auto Mode, AWS va más lejos y automatiza buena parte del compute, el networking, el almacenamiento y el load balancing del clúster. Eso reduce bastante la carga operativa, pero seguimos desplegando Pods, Services, Deployments y el resto de las APIs de Kubernetes.
Para entender por qué un clúster real tiene tantas piezas, merece la pena ver dónde encajan el autoescalado y los add-ons.
HPA y Karpenter no escalan lo mismo
El Horizontal Pod Autoscaler (HPA) puede decidir que una aplicación necesita más Pods, pero esos Pods necesitan un sitio donde ejecutarse. Ahí entra Karpenter, que puede aprovisionar y retirar nodes EC2 según las necesidades de scheduling del clúster.
flowchart LR
    M[Métricas] --> HPA[HPA]
    HPA -->|Más réplicas| P[Pods]
    P -->|No caben| K[Karpenter]
    K -->|Añade capacidad| N[EC2 Nodes]
    N --> P
Son dos capas distintas: HPA escala la aplicación y Karpenter escala la infraestructura que la ejecuta. EKS Auto Mode usa Karpenter para automatizar este escalado de compute.
Los add-ons completan el clúster
Los add-ons aportan las capacidades operativas que Kubernetes necesita para integrarse con AWS. Algunos habituales son:
Amazon VPC CNI, para el networking de los Pods.CoreDNS, para el DNS interno.EBS CSI Driver, para el almacenamiento persistente.EKS Pod Identity Agent, para acceder a servicios de AWS.AWS Load Balancer Controller, para integrar Services e Ingress con ALB y NLB.
En EKS Auto Mode varias de estas capacidades dejan de ser componentes que operamos nosotros y pasan a estar gestionadas por AWS. Hay, por tanto, distintas formas de operar EKS, y no todas tienen la misma complejidad.
Lo que sigue siendo tuyo
Incluso con EKS seguimos tomando decisiones sobre:
requestsylimits;- escalado de Pods y despliegues;
- observabilidad, seguridad y RBAC;
- secretos y configuración;
- versiones de Kubernetes, Helm charts y políticas;
- troubleshooting y los add-ons o controllers propios.
Auto Mode quita varias responsabilidades de infraestructura y me parece un avance interesante.
Si el equipo no necesita Kubernetes, seguimos habiendo añadido Kubernetes, aunque sea con Auto Mode. Esa distinción importa.
Cuándo sí lo usaría
Kubernetes empieza a tener mucho sentido cuando hay un motivo concreto para asumir esa plataforma. Por ejemplo:
- ya existe una plataforma Kubernetes común en la organización;
- necesitamos herramientas, Operators o CRDs específicos de Kubernetes;
- necesitamos un modelo común entre cloud, on-premises o distintos entornos Kubernetes;
- estamos construyendo una plataforma para muchos equipos y workloads;
- necesitamos capacidades avanzadas de scheduling o de extensibilidad.
Lo que no me parecen razones suficientes por sí solas son frases como «tenemos microservicios» o «usamos containers». Amazon ECS también ejecuta containers, AWS Lambda resuelve muchísimas APIs y procesos sin administrar containers, y algunos frontends ni siquiera necesitan compute.
Mi problema con Kubernetes, por tanto, no es que sea malo, sino que su complejidad tiene un coste permanente. Cada concepto, controller, add-on o capa de abstracción nuevos es algo que alguien tendrá que entender cuando falle un viernes por la tarde, y por eso sigo prefiriendo serverless y servicios gestionados siempre que encajen con el problema. No usaría Kubernetes porque sea potente, sino cuando necesite justo las capacidades que justifican esa potencia.
Eso nos deja con una pregunta más útil que aprender Kubernetes por sí mismo: cómo sé cuándo necesito EKS y cuándo me conviene más Lambda, ECS o incluso EC2. Es lo que cuento en la Parte 2, ¿De verdad necesitas Kubernetes? Lambda vs ECS vs EKS en AWS.