¿De verdad necesitas Kubernetes? Lambda vs ECS vs EKS en AWS
Kubernetes en AWS
Qué es Kubernetes y qué aporta Amazon EKS, y cómo decidir entre Lambda, ECS, EKS o EC2 en AWS exigiendo un requisito concreto antes de asumir la complejidad de Kubernetes.
2 artículos
En la Parte 1 de esta serie conté por qué Kubernetes me parece una plataforma muy potente y también muy compleja. Ahora toca la pregunta que para mí pesa bastante más: si realmente lo necesito para esta aplicación. Aquí no comparo servicios uno a uno. Cuento en qué orden me hago las preguntas y qué requisitos busco antes de decir que sí a Amazon EKS.
Mi sesgo en AWS es conocido: si puedo resolver el problema con serverless de forma limpia, suelo empezar por ahí. No porque AWS Lambda sea siempre mejor ni porque los containers sean malos, sino porque cada capa de infraestructura que puedo evitar es una capa que no tengo que parchear, escalar, actualizar, monitorizar ni explicar después.
Serverless tampoco sirve para todo. Por eso, en vez de empezar eligiendo tecnología, empiezo preguntando qué necesita el workload.
Primero compute, y solo si hace falta
Imaginemos una SPA en React. Tras el build tenemos JavaScript, HTML, CSS e imágenes estáticas. Podríamos empaquetarla en un container y desplegarla en ECS o EKS, pero la pregunta correcta es otra: por qué necesito un servidor para servir ficheros estáticos. En muchos casos basta con esto:
flowchart LR
    U[Usuario] --> CF[CloudFront]
    CF --> S3[S3]
Ni Pods, ni Tasks, ni EC2. De ahí sale mi primera regla: no elijas el tipo de compute hasta confirmar que necesitas compute.
Si lo necesito, intento empezar por serverless. Cuando la aplicación encaja en un modelo basado en eventos o en peticiones independientes, AWS Lambda suele ser mi primera opción, junto a Amazon API Gateway, Amazon DynamoDB o Amazon S3:
flowchart LR
    A[API Gateway] --> L[Lambda]
    L --> D[DynamoDB]

    S[S3] --> E[Evento]
    E --> L2[Lambda]
No tengo que decidir cuántos servidores necesito, dónde ejecutarlos ni cómo escalan. AWS se ocupa de la infraestructura y yo me centro en la lógica de la aplicación.
Eso es lo que busco cuando hablo de serverless: no que no existan servidores, sino que no formen parte de mi modelo operativo diario.
Lambda suele encajar especialmente bien cuando:
- el trabajo es event-driven;
- cada ejecución puede ser independiente;
- la aplicación tolera el modelo de ejecución de Lambda;
- quiero escalar por invocación;
- quiero minimizar la infraestructura que tengo que operar.
Cuando esto deja de encajar, entonces miro containers.
Tener containers no significa necesitar Kubernetes
Esta es probablemente la idea más importante del artículo. Supongamos que necesito un proceso de larga duración, una aplicación que ya viene containerizada o un runtime que no encaja bien en Lambda. Perfecto: necesito containers. Pero a partir de ahí hay dos caminos muy distintos:
flowchart TB
    C[Container]
    C --> ECS[ECS<br/>orquestación nativa AWS]
    C --> EKS[EKS<br/>Kubernetes]
Amazon ECS permite ejecutar y escalar containers con un modelo nativo de AWS; Amazon EKS permite hacerlo con Kubernetes. Los dos pueden ejecutar microservicios, balancear tráfico, escalar aplicaciones y desplegar en varias Availability Zones. Por eso la pregunta no es si tengo containers, sino qué necesito de Kubernetes que no me dé simplemente un orquestador de containers.
Cómo sé si necesito Kubernetes
Un árbol de decisión que se limite a decir ¿necesitas Kubernetes? Sí: EKS; no: ECS no sirve de mucho: si nos hacemos la pregunta es precisamente porque aún no sabemos la respuesta. Lo que busco son requisitos explícitos de Kubernetes, y los que considero válidos son estos:
- Ya existe una plataforma Kubernetes en la organización. Si hay un equipo de plataforma que proporciona GitOps, observabilidad, políticas, seguridad, Helm charts, Operators y una forma estándar de desplegar, Kubernetes ya forma parte del modelo operativo y añadir otro workload puede ser sencillo.
- Necesito algo específico del ecosistema Kubernetes. Hay productos y plataformas diseñados alrededor de Helm, CRDs u Operators, y si Kubernetes es parte natural de cómo se instalan u operan, EKS tiene bastante más sentido.
- Necesito portabilidad Kubernetes de verdad. Puede haber un requisito real de ejecutar los mismos workloads entre AWS, on-premises u otros entornos Kubernetes.
- Estoy construyendo una plataforma para muchos equipos. La complejidad de Kubernetes se amortiza mucho mejor cuando una plataforma común da servicio a decenas de equipos y workloads que cuando se despliegan tres microservicios.
- Necesito scheduling o extensibilidad avanzados. GPUs, topologías especiales, Operators, recursos personalizados o automatizaciones construidas sobre la API de Kubernetes son razones totalmente válidas.
La palabra importante en la portabilidad es «real». No asumiría toda la complejidad de Kubernetes por un hipotético «quizá algún día cambiemos de cloud».
Si no encuentro algo parecido, Amazon ECS merece evaluarse antes que EKS.
Lo que no significa que necesites Kubernetes
No elegiría EKS únicamente porque:
- tenga microservicios o use Docker;
- tenga muchas APIs;
- necesite autoscaling o alta disponibilidad;
- necesite rolling deployments, service discovery o un load balancer.
Kubernetes puede hacer todo eso, pero ECS también, con un modelo operativo bastante más pequeño.
Que Kubernetes pueda resolver un problema no significa que Kubernetes sea necesario para resolverlo.
El árbol de decisión, Fargate y EC2
Con todo esto, mi forma de pensarlo es más o menos esta:
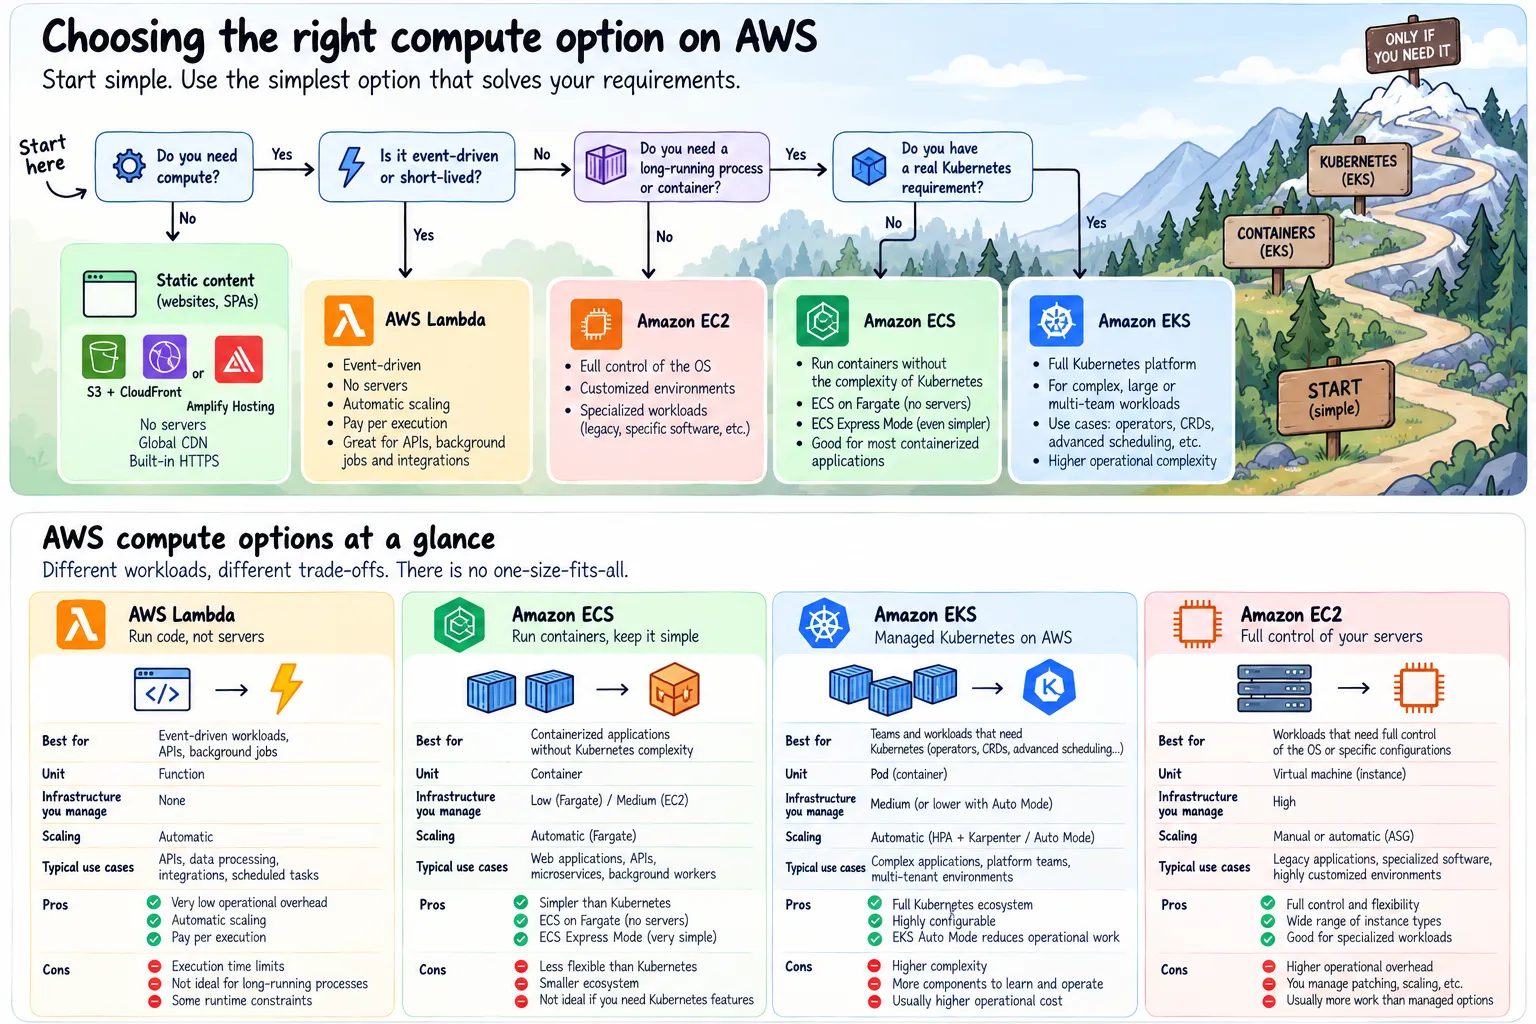 La idea no es memorizar un árbol perfecto, sino empezar por la opción más sencilla y exigir una razón concreta antes de asumir más infraestructura y más carga operativa.
flowchart TB
    A{¿Necesito compute?}

    A -->|No| STATIC[Static hosting<br/>S3 + CloudFront / Amplify]
    A -->|Sí| B{¿Encaja bien como<br/>ejecución event-driven<br/>o función?}

    B -->|Sí| L[Lambda]
    B -->|No| C{¿Necesito un proceso<br/>o container persistente?}

    C -->|Sí| D{¿Tengo un requisito<br/>específico de Kubernetes?}
    D -->|Sí| EKS[EKS]
    D -->|No| ECS[ECS]

    C -->|No / necesito control de VM| EC2[EC2]
No es un algoritmo universal y siempre habrá excepciones. Lo que me gusta de este árbol es que cada salto hacia más infraestructura tiene que estar justificado por un requisito.
AWS Fargate aparece muchas veces en estas comparaciones como si fuera otra alternativa a ECS o EKS, pero responde a otra pregunta.
ECS y EKS responden a cómo orquesto mis containers. Fargate responde a quién gestiona la infraestructura donde se ejecutan.
Se pueden ejecutar workloads de ECS sobre Fargate sin administrar las instancias EC2 subyacentes, y también existe integración de Fargate con EKS para determinados Pods. La combinación ECS + Fargate me parece especialmente interesante cuando necesito containers pero quiero mantener una filosofía cercana a serverless: ejecutar el workload sin administrar directamente los hosts.
AWS ofrece además ECS Express Mode, que simplifica todavía más ciertos despliegues web containerizados al configurar automáticamente buena parte de Fargate, el networking, el load balancing y el autoscaling.
Amazon EC2 sigue teniendo sentido cuando necesito una máquina de verdad. Por ejemplo, para:
- control del sistema operativo;
- software legacy difícil de adaptar;
- configuración específica del host;
- appliances;
- requisitos de red o almacenamiento muy concretos.
EC2 da muchísimo control y también devuelve muchas responsabilidades.
Está bien si necesito ese control. Lo que intento evitar es asumirlo cuando no me aporta nada.
Comparación rápida
| Lambda | ECS | EKS | EC2 | |
|---|---|---|---|---|
| Modelo | Funciones | Containers AWS | Kubernetes | Máquinas virtuales |
| Infraestructura a gestionar | Muy poca | Baja / media | Media / alta | Alta |
| Control | Bajo | Medio | Alto | Muy alto |
| Complejidad operativa | Baja | Baja / media | Alta | Alta |
| Kubernetes | No | No | Sí | Solo si lo instalas |
| Mi caso típico | APIs y eventos | Container sin necesidad de Kubernetes | Requisito real de Kubernetes | Necesidad real de host/OS |
No interpreto esta tabla como una escala en la que más control signifique mejor. Suele ocurrir lo contrario: quiero asumir únicamente el control que necesito.
Algunos ejemplos ayudan a verlo:
- Un frontend React estático (
React -> build -> S3 -> CloudFront) no necesita compute. - Procesar un fichero subido a S3 (
S3 -> evento -> Lambda -> resultado) encaja de forma natural en Lambda. - Una API containerizada sin requisitos de Kubernetes, con varios microservicios Docker, autoscaling y balanceo de carga, no me obliga a usar Kubernetes: ECS + Fargate sería una de las primeras opciones a evaluar.
- Una plataforma común para decenas de equipos basada en GitOps, Helm y Operators cambia el planteamiento por completo. Kubernetes ya no es solo dónde ejecuto el container, sino la API de la plataforma, y EKS tiene mucho más sentido.
- Una aplicación legacy que necesita control completo del host probablemente sea EC2. No intentaría convertirla en serverless ni en Kubernetes solo por ser más moderno.
Una arquitectura real no tiene por qué elegir una sola opción
Una plataforma puede acabar perfectamente así:
flowchart LR
    U[Usuario] --> CF[CloudFront]
    CF --> S3[S3 - frontend]
    CF --> API[API Gateway]
    API --> L[Lambda]
    L --> DB[(DynamoDB)]

    L --> Q[SQS]
    Q --> ECS[ECS workload]

    EKS[EKS workload especializado]
Y no pasa nada. Uno de los puntos fuertes de AWS es poder elegir abstracciones distintas para workloads distintos, y no hay premio por conseguir que todo se ejecute en Kubernetes.
Mi regla final es empezar siempre por la solución con menos infraestructura que tenga que operar:
- Si puedo servirlo de forma estática, no añado compute.
- Si encaja en Lambda, normalmente prefiero serverless.
- Si necesito containers, evalúo ECS.
- Si de verdad tengo requisitos de Kubernetes, EKS puede ser una plataforma excelente.
La arquitectura no debería empezar por «quiero usar EKS», sino terminar en EKS cuando los requisitos lo hayan justificado.
Kubernetes es muy potente, y precisamente por eso no creo que debamos usarlo para todo.